Найти в Дзене
1 неделя назад

Как организовать аварийное восстановление ИТ-системы: от плана до реальных испытаний

Как превратить резервную инфраструктуру, технические инструкции и обязательства провайдера в план, который сможет выполнить дежурная команда — без постоянного участия его автора. Представим учебную ситуацию. Ночью критический сервис перестаёт принимать заказы. Резервная площадка доступна, инженеры готовы действовать, состояние данных можно проверить. Но архитектор, который обычно разрешает переключение, не отвечает. Провайдеру необходимо подтвердить полномочия заявителя. Две команды открыли разные версии инструкции...

1 неделя назад

Как сменить облачного провайдера и сохранить стабильность работы бизнеса

Практическое руководство для CTO и ИТ-директора: от проверки совместимости Yandex Cloud с целевой инфраструктурой до переноса данных, нагрузочной приёмки и контролируемого переключения трафика. Перенести высоконагруженное приложение в другое облако — не то же самое, что арендовать там виртуальные машины. Даже когда оба провайдера предлагают Kubernetes, PostgreSQL и S3-совместимое хранилище, различия в драйверах дисков, управлении доступом, доступных расширениях СУБД и сетевых сервисах способны нарушить работу production...

1 неделя назад

Правило 3-2-1: как защитить базы данных от потери

Практическое руководство для CTO и ИТ-директора высоконагруженного сервиса: как спроектировать независимые копии PostgreSQL, защитить WAL, рассчитать восстановление после потери ЦОД и доказать достижимость RPO/RTO. После потери дата-центра приложение можно развернуть на новых серверах. Восстановить исчезнувшие бизнес-данные гораздо сложнее. Причём даже три сохранённых backup-файла не гарантируют результата: они могут лежать на одном storage, удаляться из одной учётной записи или требовать ключа шифрования, который остался в недоступном ЦОД...

1 неделя назад

Как спроектировать георезервирование приложения в двух дата-центрах

Практическое руководство для CTO и ИТ-директора высоконагруженного сервиса: как выбрать архитектуру двух ЦОД, организовать репликацию данных, исключить split-brain, рассчитать резервную мощность и проверить, что приложение действительно переживёт потерю основной площадки. Потеря дата-центра — один из наиболее тяжёлых сценариев для высоконагруженного приложения. В один момент могут стать недоступны не только серверы приложения, но и базы данных, Kubernetes-кластеры, системы хранения, CI/CD, Container Registry, мониторинг, VPN, секреты и инструменты администрирования...

1 неделя назад

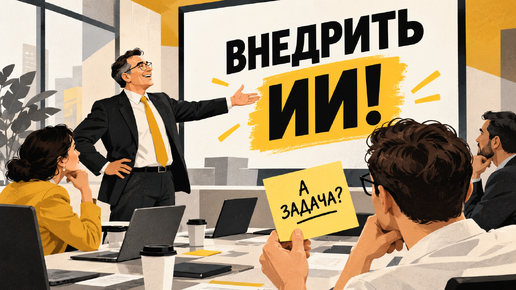
«Нам срочно нужен ИИ!» А что он будет делать, решим потом

— Коллеги, в этом квартале нам необходимо внедрить искусственный интеллект. — В какие процессы? — Пока неважно. Посмотрите, что делают конкуренты. Через три месяца сотрудники прошли обучение по промптам, компания закупила подписки на нейросети, а ИТ-отдел подготовил презентацию о перспективах внедрения. В отчёте руководству появилась новая строчка: «Используем искусственный интеллект». Осталось разобраться с небольшим нюансом: какую работу теперь выполняет ИИ? Ситуация вымышленная, но вполне узнаваемая...

Если нравится — подпишитесь
Так вы не пропустите новые публикации этого канала
Покупайте СтеллыИ дарите их за контент