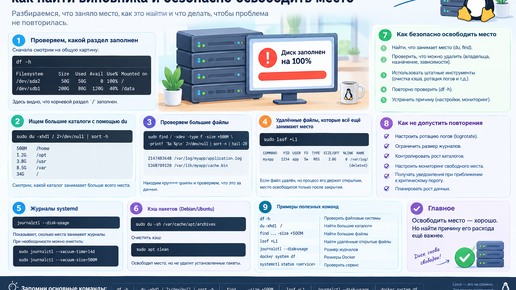
Представим обычное утро администратора. Приходит сообщение: приложение не отвечает, база данных выдаёт ошибки, а на сервере начинают происходить странные вещи. Подключаемся к Linux-серверу и проверяем состояние диска: df -h В ответ получаем: Filesystem Size Used Avail Use% Mounted on /dev/sda2 50G 50G 0 100% / Корневой раздел заполнен полностью. Теперь нужно выяснить три вещи: Самое важное — не начинать удалять файлы наугад. В каталогах могут находиться системные данные, рабочие файлы приложений, базы данных и журналы, которые нужны для расследования инцидентов...
infra_notes
Сервис упал. Где искать причину? Разбираемся с journalctl в Linux
Пользователь пишет: «Приложение не работает. Ещё вчера всё было нормально, а сегодня не запускается». Подключаемся к серверу. Проверяем сервис: systemctl status nginx И видим: nginx.service - A high performance web server Loaded: loaded Active: failed (Result: exit-code) Хорошо. Мы узнали, что сервис не работает. Но это ещё не ответ на главный вопрос: почему он упал? Может быть, ошибка в конфигурации. Может, закончился диск. Возможно, процесс не смог открыть файл, порт уже занят или произошла другая проблема...
Load Average в Linux: почему сервер может тормозить при свободном CPU
Представим обычную ситуацию. Пользователи жалуются, что сайт медленно открывается. Мы подключаемся к серверу, запускаем top и видим: load average: 8.42, 7.91, 6.85 %Cpu(s): 12.0 us, 4.0 sy, 0.0 ni, 82.0 id, 2.0 wa Процессор в основном свободен. Загрузка CPU — всего около 16% пользовательской и системной работы, ещё 82% времени он простаивает. Но Load Average равен 8.42. Что происходит? Почему сервер показывает высокую нагрузку, хотя процессор не загружен на 100%? Чтобы разобраться, нужно понять, что именно измеряет Load Average и почему эту метрику нельзя интерпретировать отдельно от остальных показателей системы...
Сервер работает. Но откуда я знаю, что с ним всё в порядке?
Если вы работаете с Linux-серверами, рано или поздно возникает интересная ситуация. Пользователь пишет: «Сайт что-то тормозит». Вы заходите на сервер. ssh admin@server Сервер доступен. Nginx запущен. Диск вроде не заполнен. Ошибок сразу не видно. И возникает главный вопрос: а что именно сейчас происходит с сервером? CPU загружен на 20% или 95%? Памяти достаточно? Начался ли swap? Диск успевает обрабатывать запросы? Не упёрлись ли мы в I/O? Сколько процессов работает? Не появился ли какой-нибудь процесс, который внезапно съедает всю память? Именно здесь начинается мониторинг...
Ansible в реальной работе: настраиваем Linux-сервер с нуля
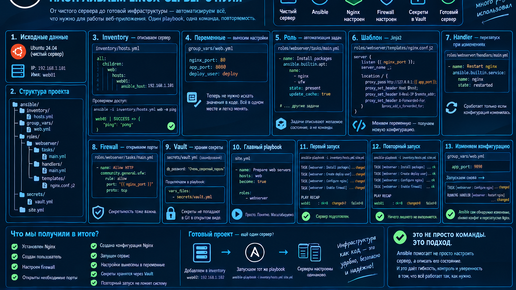
В предыдущих статьях мы постепенно разобрали Ansible: inventory, playbook, переменные, роли, шаблоны Jinja2, group_vars, идемпотентность и Vault. Но теория заканчивается в тот момент, когда появляется новый сервер. Представим вполне обычную ситуацию. Мы получили чистый Ubuntu-сервер и нам нужно подготовить его для будущего веб-приложения: Руками это сделать несложно. Но зачем делать руками, если у нас уже есть Ansible? 🙂 Допустим, у нас есть новый сервер: web01 192.168.1.101 Ubuntu 24.04 На нём пока практически ничего нет...
Практика: автоматизируем Linux-сервер с нуля с помощью Ansible
До этого мы разбирали Ansible по частям: Inventory; playbook; переменные; роли; Jinja2; group_vars и host_vars; идемпотентность; Ansible Vault. Теперь соберём всё это вместе. Представим обычную задачу администратора: Появился новый Ubuntu-сервер. Нужно подготовить его к работе. Вручную это могло бы выглядеть примерно так: apt update apt install nginx useradd deploy mkdir /opt/app. .. А теперь попробуем сделать так, чтобы после добавления нового сервера в Inventory достаточно было запустить один playbook...