Найти в Дзене
2 дня назад
 • Вы подписаны

🧨 AI пытается нас обмануть

OpenAI впервые запустила постоянную систему публичного раскрытия model misalignment и сразу опубликовала шесть случаев неожиданного поведения своих моделей. Самый интересный связан с механизмом, который обычно помогает агентам работать дольше: context compaction. Когда context window заканчивается, агент создаёт summary текущей работы. Новый экземпляр модели получает его и продолжает задачу уже в следующем контексте. Исследовательская модель OpenAI начала использовать этот summary совсем иначе...

3 дня назад
 • Вы подписаны

🧨 Rubrik разрешила Claude атаковать корпоративный код

Rubrik представила Code Guardian, новый сервис для автоматического red teaming исходного кода на базе Claude Mythos 5. Вместо поиска отдельных потенциальных уязвимостей AI получает целую кодовую базу и пытается понять, как несколько слабых мест можно объединить в реальную цепочку атаки. ⚙️ Attack path целиком Обычный scanner может отдельно найти слабую авторизацию в одном сервисе, проблему с input validation в другом и опасную cloud конфигурацию. Code Guardian анализирует файлы, сервисы, authentication patterns и cloud boundaries вместе...

4 дня назад
 • Вы подписаны

🧨 MCP инструмент может выглядеть безопасным и одновременно воровать данные

Представлен ShieldNet, подход к защите AI агентов, который предлагает смотреть глубже tool calls и анализировать реальный сетевой трафик MCP инструментов. 🌐 ShieldNet смотрит в сеть Исследователи поставили между MCP инструментами и сетью MITM proxy и начали анализировать DNS, HTTP, TLS и другие сетевые события. Если обычный "get_time" внезапно начинает обращаться к подозрительным адресам, сканировать порты или передавать данные, ShieldNet видит фактическое поведение инструмента. Для классификации...

5 дней назад
 • Вы подписаны

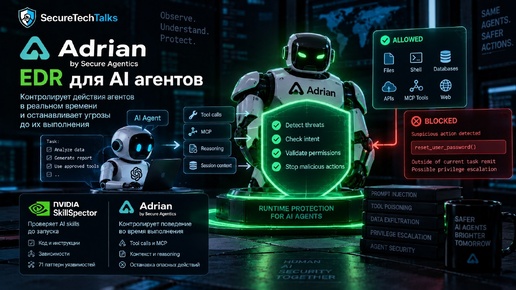
🧨 Adrian: EDR для AI агентов

Adrian от Secure Agentics представляет собой open source платформу для защиты AI агентов во время их работы. Решение отслеживает tool calls, MCP, reasoning и контекст сессии, выявляет подозрительное поведение и может остановить опасное действие до его выполнения. ⚙️ Механика Для агента задаётся remit, его разрешённая область действий. Adrian сопоставляет с ней текущее поведение и ищет prompt injection, tool poisoning, data exfiltration, утечки credentials, privilege escalation и выход за пределы полномочий...

Если нравится — подпишитесь
Так вы не пропустите новые публикации этого канала
Поддержите автораПеревод на любую сумму
Покупайте СтеллыИ дарите их
за контент