45 минут назад
• Вы подписаны
Начиная с версии 2.1.277 Claude Code автоматически ищет AGENTS.md, если в проекте нет CLAUDE.md. То есть проектные инструкции для ИИ агента больше не обязательно дублировать специально под Claude. Если репозиторий уже использует AGENTS.md, Claude Code сможет подхватить его сам...
Команда Hacktron начала с официального форума OpenAI на Discourse. Они нашли уязвимость в обработке HEIC и HEIF изображений. Специально подготовленный файл проходил через ImageMagick и уязвимую библиотеку libheif, что позволяло выполнить код на сервере. Дальше обнаружилась более опасная связка. Форум использовал вход через аккаунт OpenAI, и контроль над сервером позволял перехватывать пользовательские сессии. Так исследователи получили доступ к ChatGPT и Codex нескольких пользователей, включая сотрудника OpenAI...
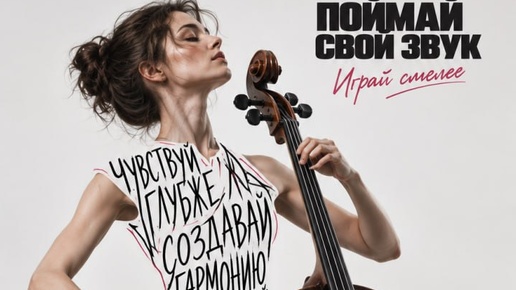
Создать один готовый постер для редакционной рекламной кампании, 9:16. Человеческое тело, сконструированное из неровных черных рукописных слов. Удалить сфотографированный торс и верхнюю одежду; заменить эту область негативным пространством цвета фона, заполненным буквами так, чтобы внешние края букв формировали силуэт тела. Это НЕ должно выглядеть как текст, напечатанный на белой футболке. Голова, шея, руки, кисти и ноги остаются фотографическими и соединенными — один цельный человек. Буквы тела: тонкие, длинные, свободные рукописные штрихи одним мазком фломастера...
🎬 Одно лицо, девять эмоций. Хотите так же? Заходите и пробуйте VanSeedanceBot собрал популярные модели для генерации контента прямо в Telegram: Seedance 2.0 и 2.5, Kling 3.0 и Veo 3.1 для видео, Nano Banana и GPT Image для картинок, Suno для музыки. Никаких отдельных аккаунтов и подписок. Платите только за генерации. Видео от 20 ₽, картинка 3 ₽, два трека в Suno 11 ₽. Баланс можно пополнить российской картой, через СБП, криптовалютой или Telegram Stars. Если не хочется разбираться с промптами, есть 25+ готовых сценариев. Загружаете фото и получаете готовое видео со своим лицом...
Qwen3.8-Omni-Flash это новая мультимодальная модель, которая одновременно понимает текст, изображения, аудио и видео. Контекст вырос до 1 миллиона токенов. Главное отличие от обычных мультимодальных моделей в работе со звуком. Qwen умеет анализировать аудио внутри видео, различать пространственный многоканальный звук и работать со 113 языками и диалектами. Модель также поддерживает вызов инструментов, веб-поиск и режим рассуждений...